主要表演者:负责说唱的主角
这个人向前靠近镜头,完成较长的说唱段落,并出现在最后的单人特写中。请选择你希望观众在结尾认出的那张脸;面部与肩膀清楚的人像更有利于保持身份特征。
左侧上传:主要表演者(说唱)
用熟悉的面孔,重现夜间停车场的说唱出场。分别上传主唱和开场舞者的照片,场景与动作交给 LivelyReel。The Chase Skepta AI 模板将两人的镜头交接制作成9秒视频,不需要自己写提示词。
投射你的说唱场景:两张照片,两个不同的部分
主要说唱歌手:挺身而出,对着镜头表演并带来结局。
开场舞者:抢先一步,然后移到说唱歌手后面。
9 秒 · 1:1 方形 · 高清
生成失败会自动退回积分。
THE CHASE SKEPTA AI · 照片变说唱
镜头前先出现一位开场人物,随后舞者退到后方,主唱走近镜头,普通停车场成了表演舞台。熟悉的面孔配上自信的说唱表现,就是这类视频的趣味所在。
这个页面专门用来制作这种双人说唱短片。你不必去户外拍摄、寻找停车场或自己演唱,只需提供两人的照片,再检查 AI 根据参考表演生成的成片。
查看 The Chase Skepta AI 制作步骤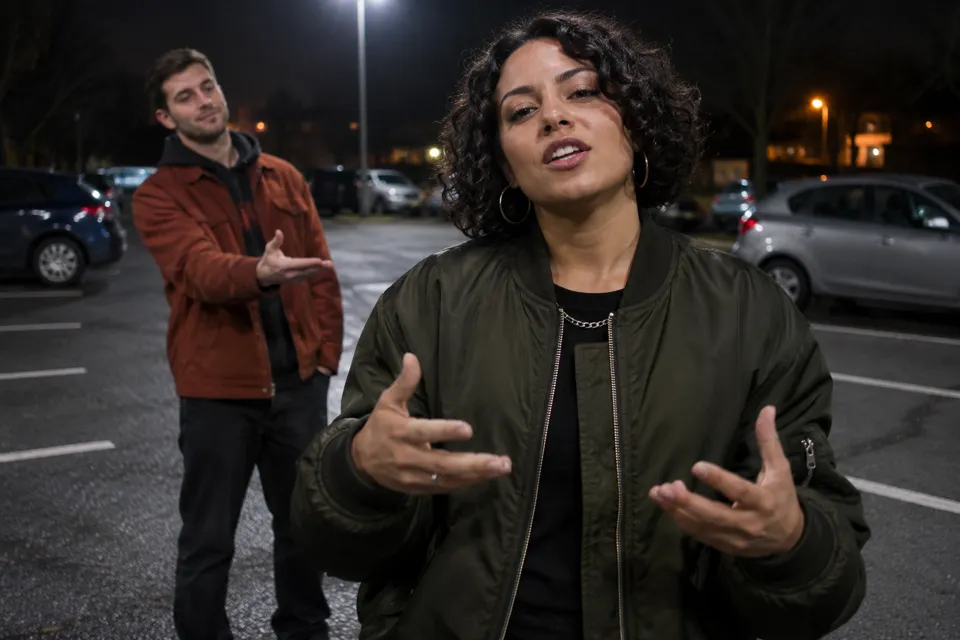
谁来占据主镜头?
两个上传框对应不同的表演任务。先决定你希望谁完成哪个动作,再把照片放进相应位置。
这个人向前靠近镜头,完成较长的说唱段落,并出现在最后的单人特写中。请选择你希望观众在结尾认出的那张脸;面部与肩膀清楚的人像更有利于保持身份特征。
左侧上传:主要表演者(说唱)
这个人先带出场景,随后将前景位置让给主唱,退到后方。他的任务是开场和背景动作,而不是与主唱一起占据整段说唱特写。
右侧上传:开场表演者(舞蹈)
角色由上传位置决定,不根据性别、衣服或肤色判断谁来唱。提交前请核对左右两张照片。
看看镜头如何交接
以下画面截取自上方播放的 LivelyReel 实际成片。检查自己的结果时,可以依次观察开场、两人的前后景分工,以及最后的主唱特写。
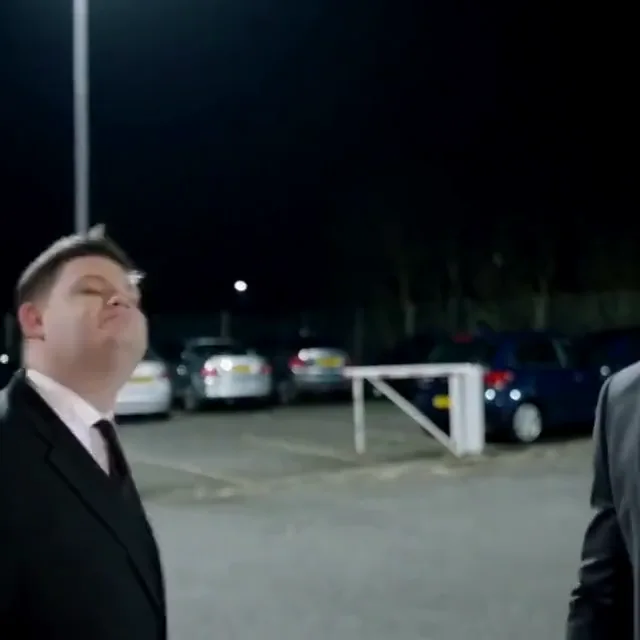
开场表演者立即搭建场景。背景仍然是夜间停车场,而不是工作室或音乐舞台。
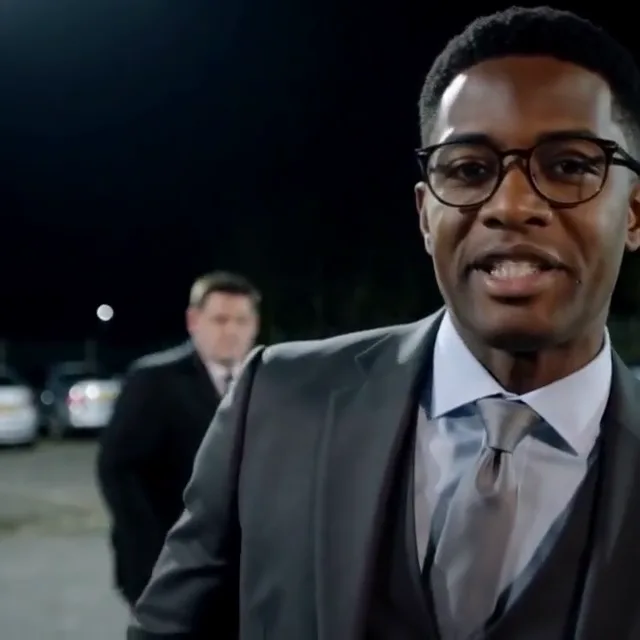
随着开幕式的结束,主要表演者逐渐靠近。将两个面保持在不同的深度使得焦点的变化可读。
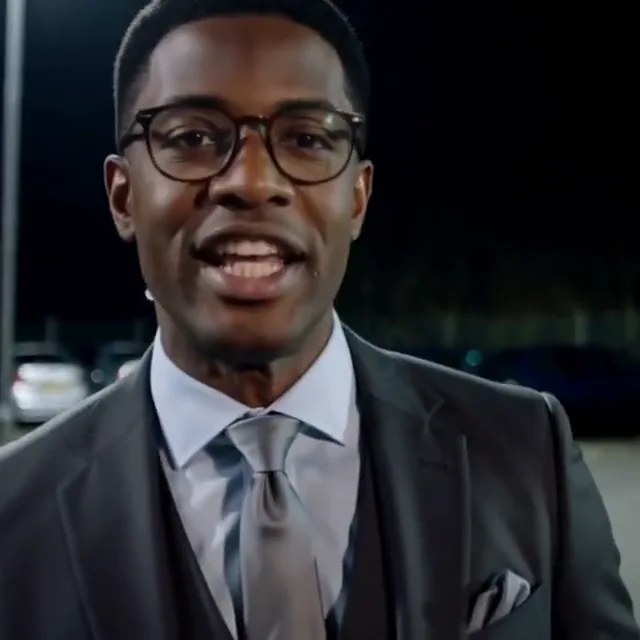
最后一个特写是说唱歌手的目光、嘴巴的动作和表情。这是一个简短的表演结束,而不是添加音乐的静态肖像。
按步骤制作
使用本页顶部的生成器即可。表演场景已经准备好,你只需选择两张照片并安排角色。
将该人添加到左侧框的“主要执行者”中。使用单独的 JPG 或 PNG,且完整的脸部可见。不要上传远处的集体照并期望该工具能够猜测主题。
将第二个人添加到开场表演者右侧的方框中。在继续之前检查两个预览。交换照片就交换角色;它不会改变编排。
确认使用照片的权限。登录的客户可以花费 30 个积分。售价 5.90 美元的单视频选项让新访客通过登录或注册并安全付款,然后返回此处。
付款后,按创建按钮即可开始。留出处理时间,然后检查两个身份和嘴部动作。在“我的视频”中提供 MP4 时下载它;完成电子邮件还提供访问权限。
让人物更容易被认出来
人物会走近镜头,照片中的面部问题也会更明显。请为两个人各选一张有用的身份参考照,不必追求相册里最夸张或最有氛围的照片。
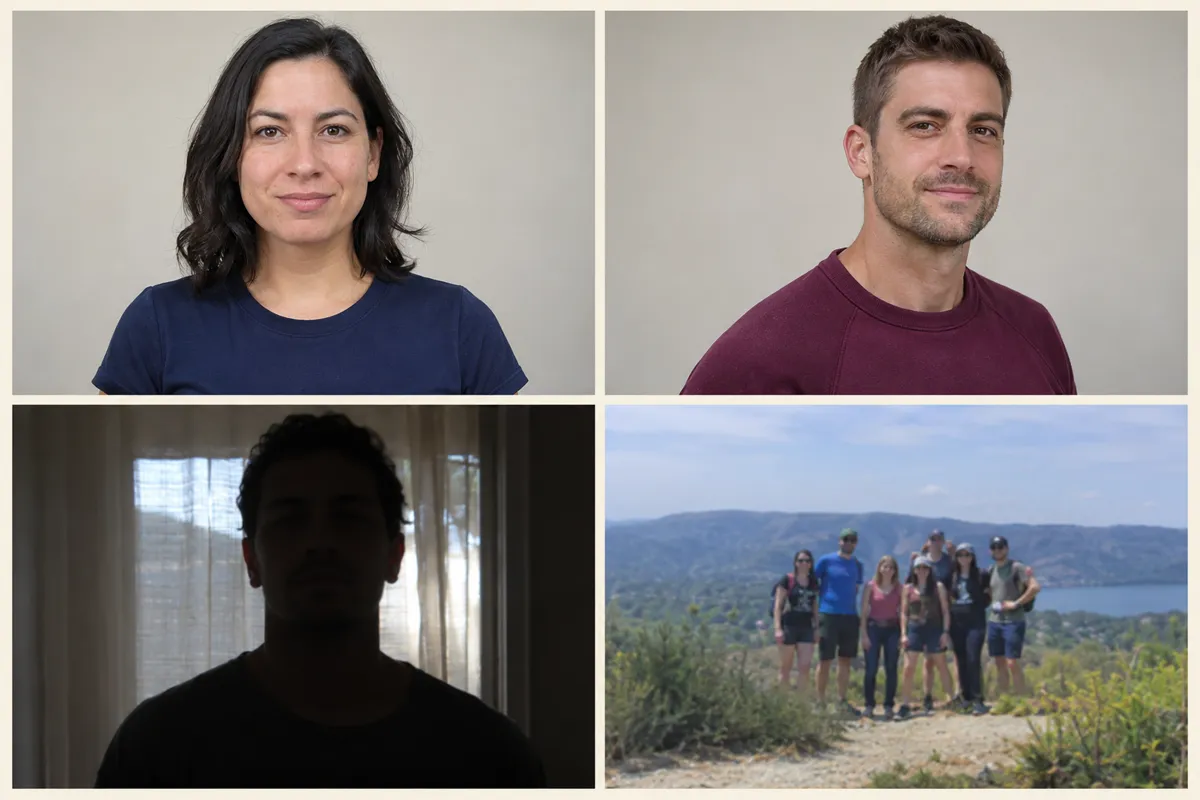
AI 生成的输入质量插图为本页面制作。这些不是上传的客户照片或承诺的视频结果。
太阳镜、用手遮住脸部或极端的侧视图可以隐藏特写镜头所需的特征。轻松、中性的表达是一个有用的起点。
强平滑、重面部滤镜和深阴影会删除信息。您的输入不需要夜间背景;该模板提供了停车场设置。
这里没有组合照片模式。即使两个人一起出现在您的原始照片库中,两张单独的肖像也会使选角决定变得明确。
在找“THE CHASE AI 滤镜”?
如果你是看了“The Chase AI 滤镜”教程来到这里,LivelyReel 可以直接用照片制作完整视频,不必在 TikTok 中寻找特效、现场录制自拍或自己描述说唱动作。这是独立的网页生成工具,并非 TikTok 官方滤镜。
The Chase AI 模板同时使用参考表演的视频与音频,引导镜头、动作和声音时序。但结果仍由 AI 生成,因此熟悉的动作不代表每次都能得到完全一致的手指、面部细节或口型。
开场白、交接、前景说唱和结束语都遵循事先准备好的参考内容。额外的注释应该关注小的视觉偏好,而不是要求另一个场景。
参考音频和视频共同指导可视化交付。您不必输入歌词或录制您的声音。分享之前回顾一下最终的嘴巴动作。
每张上传的照片都提供特定的角色参考。当框架改变时,主要说唱歌手应该保持主要说唱歌手的位置,而开场白则移到后面。
名称与音乐的关系
本页围绕 The Chase Skepta AI 这一搜索名称,提供 LivelyReel 的停车场说唱模板。这一名称不代表官方歌曲名、Skepta 的新作品,或艺术家本人对本工具的认可。
相关音乐资料中也会出现 Schooling Seniors 这个名称,Frank Medley 在 Bandcamp 以此名称发布过作品。较完整的音乐来源说明保留在 Schooling 页面;本页主要帮助你安排人物并制作说唱短片。
检查 Frank Medley 的 Bandcamp 上的曲目信用 ↗下载前检查一下
左边上传的是说唱歌手;正确的上传是开场白。如果结果与此相反,请先检查您提交的两个预览,而不是根据服装猜测。
观看到前景的过渡和最后的独奏时刻。如果身份发生变化,无障碍肖像是再次尝试的更好起点。改进的输入并不能保证。
打开播放器声音并从头到尾观看一次。一起检查嘴的时机和手的动作。预览开始静音;仅静音播放并不意味着完成的文件没有音频。
发布你的版本
不必引用歌词,也可以说明这个视频的趣味。写一句关于两人分工或主唱走向镜头的原创文案即可。
发布时请说明 AI 制作,获得照片中人物的许可,并核查音乐用于你计划用途时所需的权限。保留参考音频并不等于获得音乐授权。
在上方表单中添加两张独立人像。把负责说唱的人放在左侧“主要表演者”,把开场跳舞的人放在右侧“开场表演者”。确认使用许可,如需购买则完成支付,然后点击按钮开始生成。
使用这个工具不需要安装滤镜。LivelyReel 直接根据上传的照片在线制作视频,不需要现场拍摄;本页也不是 TikTok 官方特效。
可以。左侧照片对应主唱,右侧照片对应开场舞者。角色由上传位置决定,不根据性别、肤色或衣服判断,制作前请仔细核对标签。
不需要。模板已经包含参考场景和音频时序。你只要添加两张照片,不必为了使用这个模板而输入受版权保护的歌词或上传另一段配乐。
专用单次购买提供30积分,足够制作一支9秒、HD画质、1:1方形画幅的视频。已有用户也可使用账户余额。支付确认后,需要回到表单点击生成按钮,付款本身不会自动启动制作。
参考表演会引导表情、动作和口型时序,但成片由 AI 生成,长相、手指和口型仍可能有偏差。本页视频是真实完成的示例,不代表所有照片都能得到完全相同的效果。
页面通常预估为3–10分钟,模型排队时可能更久。完成后会显示在 My Videos 并发送邮件通知。请在24小时免费保存期内下载;生成失败会退还本次消耗的积分。
这两个 LivelyReel 页面目前使用相同的生成模板、价格和参考表演。本页主要解答 The Chase Skepta AI 的制作问题,Schooling 页面介绍另一个名称及相关音乐背景,不需要两个都购买。
制作一支说唱短片
单次购买是针对该视频的。您不必在结帐流程中途选择更大的信用包。
一次性购买;已有用户可使用30积分。
LivelyReel 的独立 AI 模板,与原表演者及素材原制作方不存在关联或背书。请仅使用有权使用的照片和媒体。